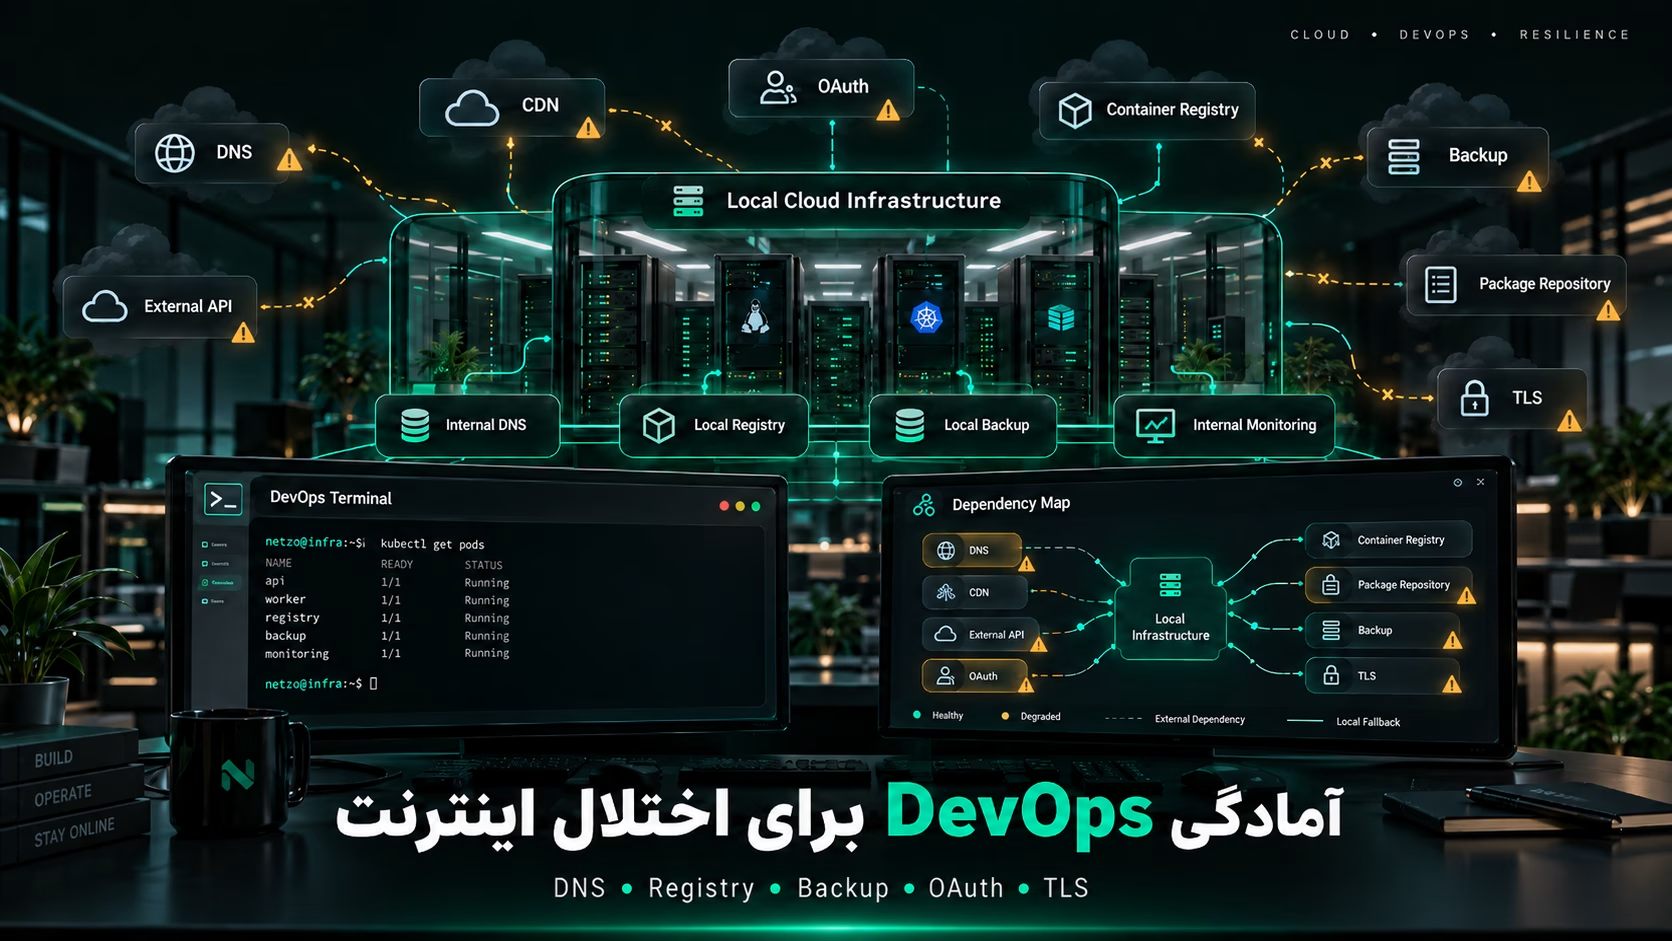
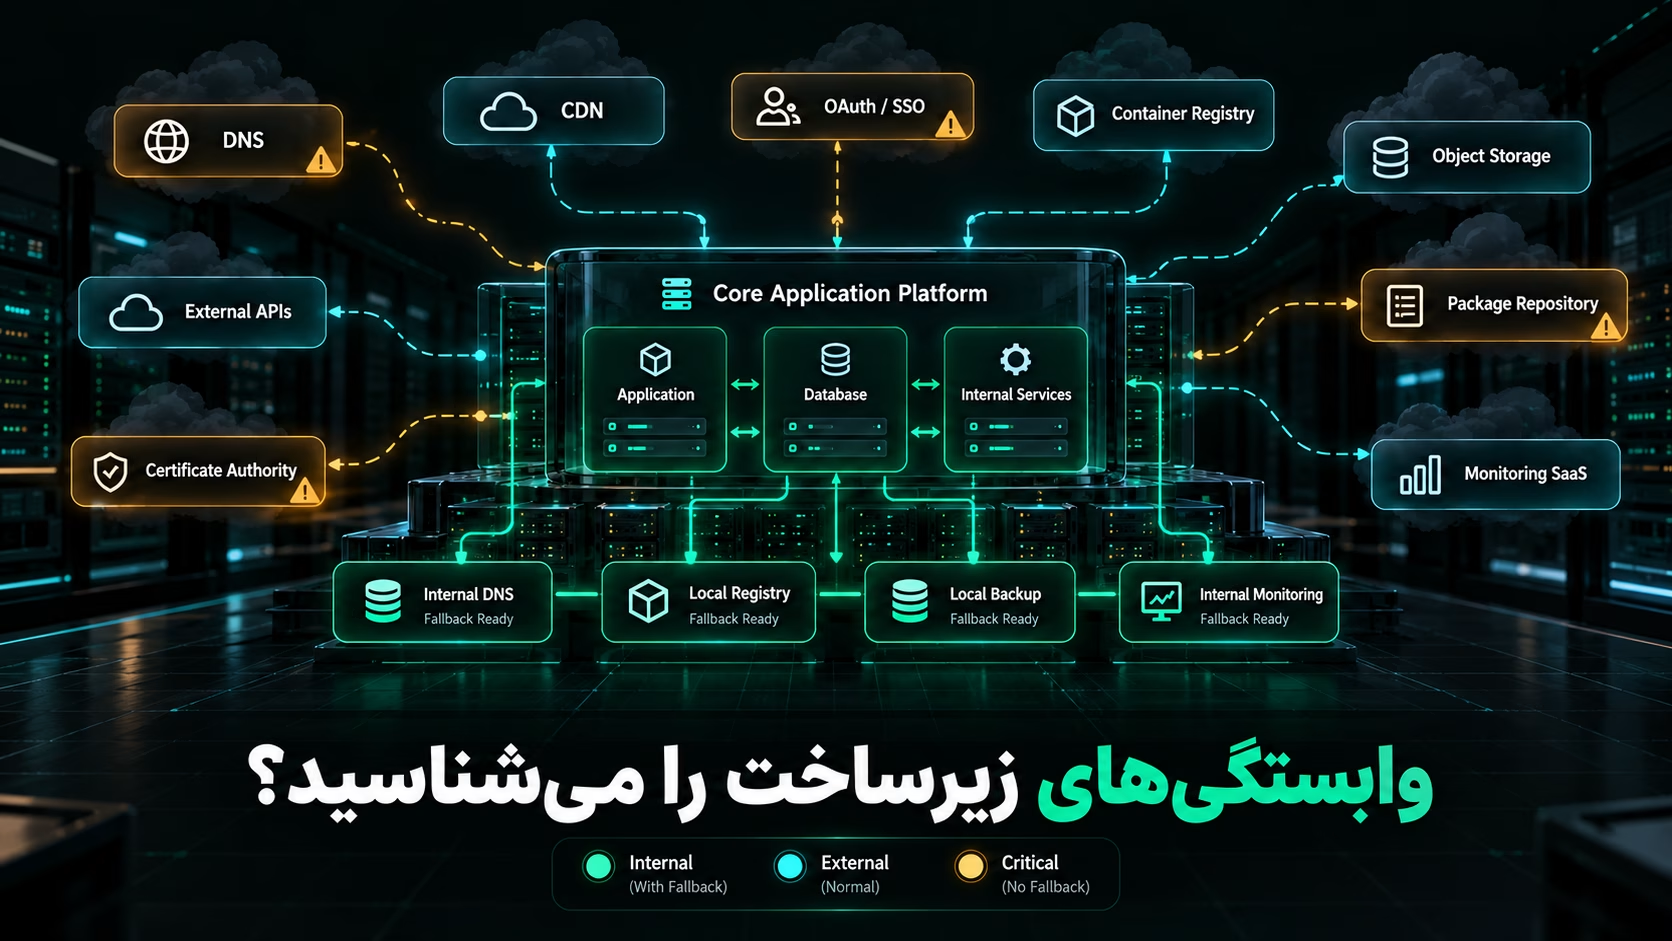
وقتی درباره پایداری زیرساخت صحبت میکنیم، معمولاً ذهنمان به سمت CPU، RAM، Storage، High Availability و Backup میرود.
اما یک نوع وابستگی مهم وجود دارد که تا زمانی که همهچیز عادی است، کمتر دیده میشود:
وابستگی به سرویسهای خارجی.
فرض کنید Application شما داخل کشور و روی یک سرور کاملاً سالم اجرا میشود، اما برای فعالیت عادی به چند سرویس بیرونی وابسته است:
DNS خارجی
CDN
Google Login
Docker Hub
GitHub Container Registry
S3
Package Repository
Let's Encrypt
Monitoring SaaS
External APIs
در شرایط عادی هیچ مشکلی وجود ندارد.
اما اگر دسترسی به اینترنت بینالملل دچار اختلال شود، ممکن است Server شما کاملاً روشن و سالم باشد ولی Application دیگر نتواند برخی عملیاتهای ضروری را انجام دهد.
در چنین شرایطی اولین سؤال نباید این باشد:
«چطور سریع یک راه دور زدن پیدا کنیم؟»
سؤال بهتر این است:
کدام بخشهای زیرساخت ما Single Point of Failure خارجی دارند و برای قطع دسترسی به آنها از قبل چه برنامهای داریم؟
این مقاله یک چکلیست عملی برای DevOps Engineerها، مدیران سیستم و تیمهای فنی است تا قبل از بحران این وابستگیها را پیدا کنند.
اول از همه: Dependency Map بسازید
قبل از تغییر DNS، ساخت Registry یا خرید Storage جدید، باید بدانید زیرساخت شما دقیقاً به چه چیزهایی وابسته است.
یک سرویس ساده ممکن است در ظاهر فقط این ساختار را داشته باشد:
User
↓
Web Server
↓
Database
اما معماری واقعی معمولاً چیزی شبیه این است:
                    DNS Provider
                         │
                         ▼
User → CDN → Load Balancer → Application
                         │
        ┌────────────────┼────────────────┐
        ▼                ▼                ▼
     Database         OAuth           External API
                         │
        ┌────────────────┼────────────────┐
        ▼                ▼                ▼
 Docker Registry     Object Storage   Monitoring
حالا فرض کنید مسیر ارتباط بین زیرساخت شما و سرویسهای خارجی محدود شود.
کدام بخش هنوز کار میکند؟
کدام بخش Degrade میشود؟
و کدام بخش بهطور کامل از کار میافتد؟
این همان چیزی است که باید قبل از بحران مشخص شود.
یک جدول ساده بسازید:
وابستگی | سرویس فعلی | خارجی است؟ | مسیر جایگزین داریم؟ | اهمیت |
|---|---|---|---|---|
DNS | Provider A | بله | خیر | Critical |
Login | Google OAuth | بله | خیر | Critical |
Container Images | Docker Hub | بله | Local Registry | Critical |
Backup | Object Storage خارجی | بله | Local Backup | Critical |
Monitoring | SaaS خارجی | بله | Prometheus داخلی | Medium |
TLS | ACME خارجی | بله | Certificate فعلی | Critical |
اگر ستون «مسیر جایگزین» در چند ردیف Critical خالی است، همانجا اولویت کار مشخص شده است.
۱. DNS را به یک نقطه شکست تبدیل نکنید
DNS یکی از اولین وابستگیهایی است که باید بررسی شود.
اگر Domain شما فقط به یک DNS Provider خارجی وابسته باشد، اختلال دسترسی به آن Provider میتواند مدیریت DNS یا در بعضی سناریوها دسترسپذیری Name Resolution را تحت تأثیر قرار دهد.
اما راهحل مناسب این نیست که ناگهان IP اصلی Origin Server را عمومی کنید.
این کار ممکن است:
معماری CDN را دور بزند
Origin IP را آشکار کند
Firewall Policy شما را بیاثر کند
مسیر امنیتی طراحیشده را تغییر دهد
راه بهتر، طراحی DNS Resilience از قبل است.
Secondary DNS را بررسی کنید
در معماریهای حساس میتوان از بیش از یک DNS Provider استفاده کرد، بهشرط اینکه Providerها و پلن مورد استفاده از Secondary DNS یا Zone Transfer پشتیبانی کنند.
ساختار مفهومی:
             Domain
                │
      ┌─────────┴─────────┐
      ▼                   ▼
Primary DNS         Secondary DNS
      │                   │
      └─────────┬─────────┘
                ▼
             Service
در چنین معماریای خرابی یک DNS Provider الزاماً کل Authoritative DNS را از دسترس خارج نمیکند.
ولی این معماری باید قبل از بحران تنظیم و آزمایش شود.
DNS سرویسهای داخلی را از DNS عمومی جدا کنید
برای سرویسهای خصوصی مثل:
database.internal
registry.internal
monitoring.internal
git.internal
بهتر است وابستگی غیرضروری به DNS عمومی خارجی نداشته باشید.
استفاده از:
Internal DNS
Private DNS
Split-horizon DNSمیتواند برای سرویسهای داخلی مفید باشد.
هدف این است که اگر اینترنت خارجی در دسترس نبود، Nodeهای داخلی همچنان بتوانند یکدیگر را Resolve کنند.
۲. CDN را با Availability اشتباه نگیرید
CDN میتواند Performance و Security بسیار خوبی ایجاد کند، ولی اگر تمام دسترسی سرویس شما فقط به یک CDN خارجی وابسته باشد، آن CDN خودش تبدیل به Dependency میشود.
قبل از بحران مشخص کنید:
آیا Origin مستقیماً قابل دسترسی است؟
اگر بله، آیا این مسیر باید Public باشد؟
Firewall در حالت Bypass چه رفتاری دارد؟
Certificate روی Origin معتبر است؟
آیا DNS Failover طراحی شده؟
آیا مسیر جایگزین واقعاً Test شده؟
نکته مهم:
Fallback نباید امنیت معماری اصلی را نابود کند.
اگر Origin در حالت عادی فقط باید Traffic متعلق به CDN را قبول کند، ایجاد یک Public Bypass بدون Access Control میتواند ریسک امنیتی جدیدی بسازد.
بهتر است مسیر اضطراری از قبل طراحی شده باشد؛ مثلاً با:
Secondary Endpoint
Alternative Reverse Proxy
Controlled Direct Access
Private Network
Secondary DNS
بسته به معماری پروژه.
۳. Login خارجی را Single Point of Failure نکنید
فرض کنید پنل مدیریتی شما فقط یک روش ورود دارد:
Sign in with Googleدر شرایط معمول این روش بسیار راحت است.
اما Authentication اکنون به زیرساخت دیگری وابسته شده است:
User
↓
Your Application
↓
Google Identity
↓
Authentication
اگر Application نتواند به سرویس Identity خارجی دسترسی پیدا کند، ممکن است User نتواند Session جدید ایجاد کند.
راهحل چیست؟
برای سرویسهای Critical، یک Break-glass Access طراحی کنید.
مثلاً:
Primary Login
→ SSO / OAuth

Emergency Login
→ Local Admin Account + Strong MFA
این Account نباید Account روزمره باشد.
ویژگیهای مناسب یک Break-glass Account:
فقط برای شرایط اضطراری
Password بسیار قوی و منحصربهفرد
MFA مستقل در صورت امکان
ذخیره Credential در محل امن
Logging کامل
Rotation دورهای
Alert هنگام استفاده
هدف حذف Google Login یا SSO نیست.
هدف این است که:
از دسترس خارج شدن Identity Provider مساوی با از دسترس خارج شدن کامل مدیریت سیستم نباشد.
Offline Access در OAuth را با Offline Login اشتباه نگیرید
بعضی OAuth Providerها Refresh Token یا Offline Access ارائه میکنند.
این قابلیت معمولاً به Backend اجازه میدهد بدون حضور User، Access Token را Refresh کند.
اما این به معنی آن نیست که:
«اگر Identity Provider کاملاً در دسترس نبود، User جدید همچنان میتواند Login کند.»
Authentication جدید همچنان ممکن است به Endpointهای Provider وابسته باشد.
بنابراین برای دسترسی مدیریتی Critical باید Failure Mode واقعی را Test کنید.
۴. Backup فقط وقتی Backup است که بتوانید Restore کنید
یکی از نکات مهم تصویر ارسالی، Backup بود.
فرض کنید تمام Backupهای Production شما فقط روی یک Object Storage خارجی قرار دارند.
از نظر Data Durability ممکن است وضعیت بسیار خوبی داشته باشید.
ولی اگر هنگام بحران به آن Storage دسترسی نداشته باشید، در همان لحظه Backup برای Recovery در دسترس شما نیست.
بهتر است برای دادههای Critical بیش از یک Copy داشته باشید.
مثلاً:
Production
   │
   ├── Local / Internal Backup
   │
   └── External Object Storage
این همان منطق جداسازی Failure Domain است.
یک نسخه Backup داخل دسترس خودتان داشته باشید
برای دادههای مهم میتوانید ترکیبی از موارد زیر داشته باشید:
Local Object Storage
Internal Backup Server
Secondary Datacenter
External S3-compatible Storage
Offline Backup
انتخاب دقیق به حجم داده، RPO، RTO و بودجه بستگی دارد.
Restore را تست کنید
این بخش از ساخت خود Backup مهمتر است.
ممکن است هر شب پیام:
Backup completed successfullyدریافت کنید، اما هیچوقت Restore نکرده باشید.
در Drill دورهای واقعاً امتحان کنید:
Backup
↓
Fresh Server
↓
Restore
↓
Application Start
↓
Data Verification
اگر Restore موفق نیست، Backup شما فقط مجموعهای از فایلهاست.
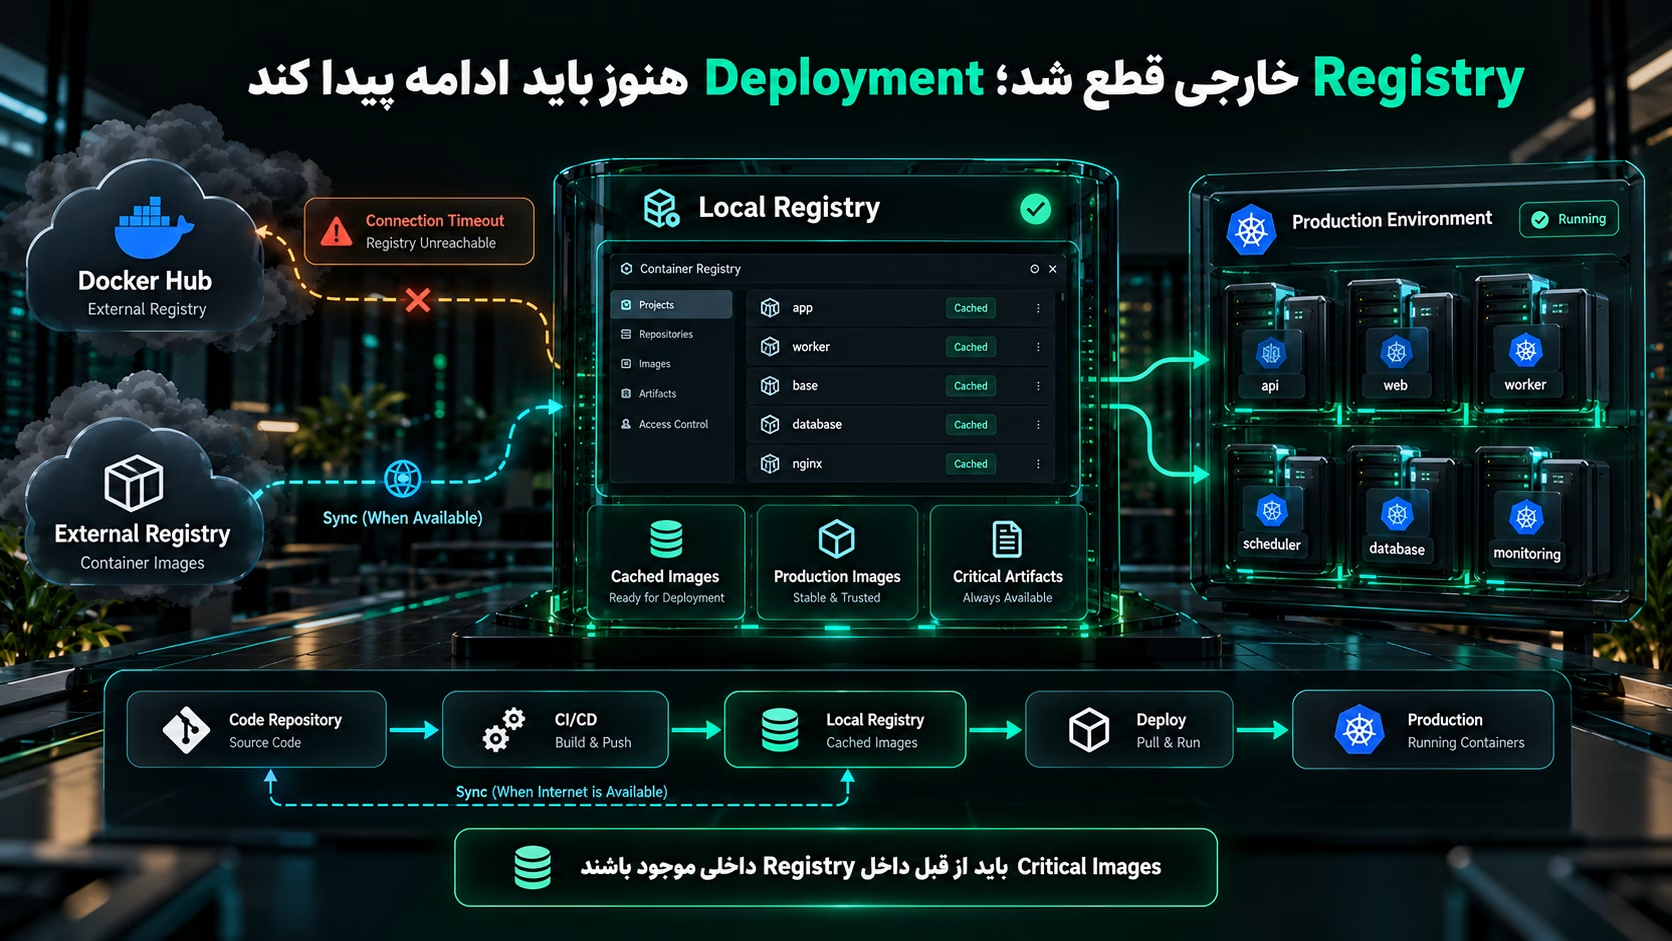
۵. Docker Hub و Registryهای خارجی را از قبل Mirror کنید
برای Infrastructureهای مبتنی بر Docker و Kubernetes این بخش بسیار مهم است.
فرض کنید Production Deployment نیاز دارد:
nginx:latest
redis:7
postgres:17
your-company/app:v42
را Pull کند.
اگر Image فقط روی Registry خارجی باشد:
Deployment
↓
docker pull
↓
External Registry
↓
Unavailable
ممکن است حتی Rollout ساده هم Fail شود.
Local Registry داشته باشید
برای Imageهای داخلی سازمان، بهترین حالت معمولاً این است که نسخه موردنیاز Production داخل Registry تحت کنترل خودتان هم وجود داشته باشد.
مثلاً:
CI/CD
  │
  ├── External Registry
  │
  └── Internal Registry
ابزارهایی مثل Harbor میتوانند برای ایجاد Private Registry، Replication و Proxy Cache استفاده شوند.
Cache خوب است، ولی Mirror از قبل بهتر است
Docker Registry Mirror یا Harbor Proxy Cache میتواند Imageهایی را که قبلاً Pull شدهاند Cache کند.
این کار بسیار مفید است.
اما یک نکته وجود دارد:
Imageای که هیچوقت Cache نشده، در زمان قطع Upstream ناگهان از هیچجا ظاهر نمیشود.
برای Imageهای Critical بهتر است قبل از بحران مطمئن شوید Artifact موردنیاز واقعاً داخل Registry داخلی وجود دارد.
برای مثال:
Base Images
Application Images
Database Images
Ingress Controller
Monitoring Stack
CI Runner
Utility Images
را از قبل نگهداری کنید.
۶. Package Repositoryها را فراموش نکنید
Container Registry تنها Dependency نرمافزاری نیست.
یک Linux Server ممکن است به اینها وابسته باشد:
APT
DNF
PyPI
npm
Composer
Maven
Go Modules
GitHub Releases
فرض کنید Application جدید را Deploy میکنید و Pipeline میخواهد:
npm installاجرا کند.
یا:
pip installیا:
apt installاگر Repository خارجی در دسترس نباشد، Deployment متوقف میشود.
برای Packageهای Critical Cache یا Mirror داشته باشید
بسته به Stack میتوانید از Repository Proxy یا Cache استفاده کنید.
مثلاً برای:
APT Repository
npm Registry
PyPI
Maven
Docker
ابزارهای مختلفی برای Cache یا Mirror کردن Dependencies وجود دارند.
برای Infrastructure حساس بهتر است Artifactهای Production Immutable و از قبل Build شده باشند.
یعنی Production Deploy تا حد امکان نیاز نداشته باشد وسط Deployment از اینترنت Package دانلود کند.
مدل بهتر:
Internet Available
↓
CI Build
↓
Artifact / Container Image
↓
Internal Registry
↓
Production Deploy
نه:
Production Deploy
↓
Download 50 Dependencies From Internet
↓
Hope Everything Works
۷. Template و Imageهای سیستمعامل را بهروز نگه دارید
این قسمت دقیقاً به کاری مرتبط است که اخیراً در نتزو انجام دادیم.
اگر Template اولیه یک VPS ماهها قدیمی باشد، Server جدید بعد از Boot ممکن است نیاز داشته باشد حجم زیادی Update دانلود کند.
در شرایط اختلال Repositoryها، این مسئله اهمیت بیشتری پیدا میکند.
به همین دلیل تمپلیتهای سیستمعامل نتزو، شامل Windows و Linux و پکیجهای موجود در تصاویر، بهروزرسانی شدهاند.
هدف این است که Server جدید از یک Baseline نرمافزاری بهروزتر شروع شود و مجبور نباشد تمام اصلاحیههای انباشتهشده گذشته را تازه بعد از Provision دریافت کند.
البته:
Template بهروز جای Patch Management آینده را نمیگیرد.
آپدیتهایی که بعد از Build شدن Template منتشر میشوند همچنان باید دریافت شوند.
اما نقطه شروع مناسبتر، وابستگی اولیه را کاهش میدهد.
۸. Certificateهای TLS را قبل از بحران بررسی کنید
فرض کنید Application کاملاً سالم است، Server روشن است و Database هم کار میکند.
اما Certificate دامنه Expire شود.
نتیجه برای User ممکن است عملاً تفاوت زیادی با Down شدن سرویس نداشته باشد.
اگر از Let's Encrypt و Certbot استفاده میکنید، وضعیت Certificateها را بررسی کنید:
sudo certbot certificatesو Renewal را Test کنید:
sudo certbot renew --dry-runهمچنین بررسی کنید Timer مربوط به Renewal فعال است:
systemctl list-timers | grep certbotبسیاری از نصبهای Certbot Renewal خودکار دارند، ولی بهتر است قبل از بحران مطمئن شوید واقعاً کار میکند.
همه Certificateها را بیدلیل Force Renew نکنید
هدف این نیست که هر بار نگران اختلال هستیم تمام Certificateها را بهزور Renew کنیم.
هدف این است که:
Expiration Monitoring داشته باشید
Renewal Automation سالم باشد
--dry-runموفق باشدCertificate نزدیک انقضا را در Window طبیعی Renewal تمدید کنید
بدانید ACME Challenge شما به چه سرویسهایی وابسته است
اگر Renewal شما از DNS API خارجی استفاده کند، همان DNS Provider خودش Dependency دیگری است.
۹. Monitoring خارجی تنها ابزار دید شما نباشد
فرض کنید تمام Monitoring شما روی یک SaaS خارجی است.
اگر اینترنت خارجی قطع شود، ممکن است:
Server Running
Monitoring Unreachable
باشد.
حالا تیم فنی نمیداند Application چه وضعیتی دارد.
برای سیستمهای Critical بهتر است حداقل بخشی از Monitoring داخل Failure Domain قابل دسترس خودتان باشد.
مثلاً:
Prometheus
Grafana
Loki
Local Syslog
Internal Alerting
بسته به معماری.
حتی اگر SaaS خارجی را حفظ میکنید، داشتن یک Dashboard و Log Store داخلی در زمان Incident بسیار ارزشمند است.
Alert Channel را هم بررسی کنید
اگر Alert فقط از طریق یک سرویس خارجی ارسال شود:
Monitoring
↓
External Messenger/API
↓
Team
قطع همان API میتواند Alerting را هم از کار بیندازد.
برای Incidentهای Critical بهتر است چند Channel مستقل داشته باشید.
۱۰. وابستگی به APIهای خارجی را Inventory کنید
این بخش معمولاً از همه سختتر است.
Application ممکن است به اینها وابسته باشد:
Payment API
SMS API
Email Provider
Maps
Captcha
Analytics
AI API
Webhook
OAuth
Storage
Search API
بعضی از آنها Critical هستند و بعضی فقط Feature جانبی.
برای هر Dependency مشخص کنید:
اگر قطع شد چه اتفاقی میافتد؟سه حالت رایج:
Fail Closed
Application کاملاً Fail میشود.
Fail Open
Application بدون آن Feature ادامه میدهد.
Graceful Degradation
Feature مربوط غیرفعال میشود ولی Core Service کار میکند.
برای بسیاری از Features غیرحیاتی، Graceful Degradation بهترین طراحی است.
مثلاً اگر Analytics خارجی در دسترس نیست، نباید Checkout فروشگاه هم از کار بیفتد.
۱۱. ابزارهای AI و SaaSهای کاری را هم در نظر بگیرید
امروز بسیاری از تیمهای فنی به ابزارهای خارجی برای:
AI Coding
Documentation
Incident Analysis
Code Search
Knowledge Base
وابسته شدهاند.
این ابزارها میتوانند بهرهوری را بسیار بالا ببرند، اما بهتر است Core Operation شرکت به یک SaaS غیرقابل دسترس وابسته نباشد.
برای بعضی تیمها داشتن:
Local Documentation
Offline Runbooks
Local Git
Local Knowledge Base
از داشتن یک مدل AI محلی هم مهمتر است.
اگر واقعاً AI بخشی از Workflow حیاتی شماست، میتوانید اجرای Local Model را هم بررسی کنید؛ ولی این موضوع باید براساس Hardware، نیاز تیم و هزینه نگهداری تصمیمگیری شود.
AI Local یک ابزار کمکی است؛ جای Documentation و Runbook را نمیگیرد.
۱۲. Runbook اضطراری بنویسید
در بحران بدترین زمان برای این سؤال است:
«حالا باید چه کار کنیم؟»
برای سناریوهای مهم Runbook داشته باشید.
مثلاً:
Scenario:
International Connectivity Lost

1. Confirm incident
2. Check internal DNS
3. Check application health
4. Verify local registry
5. Disable external-dependent jobs
6. Switch to fallback services
7. Verify backups
8. Notify team
9. Monitor capacity
10. Record changes
Runbook باید آنقدر واضح باشد که یک نفر غیر از سازنده اصلی زیرساخت هم بتواند از آن استفاده کند.
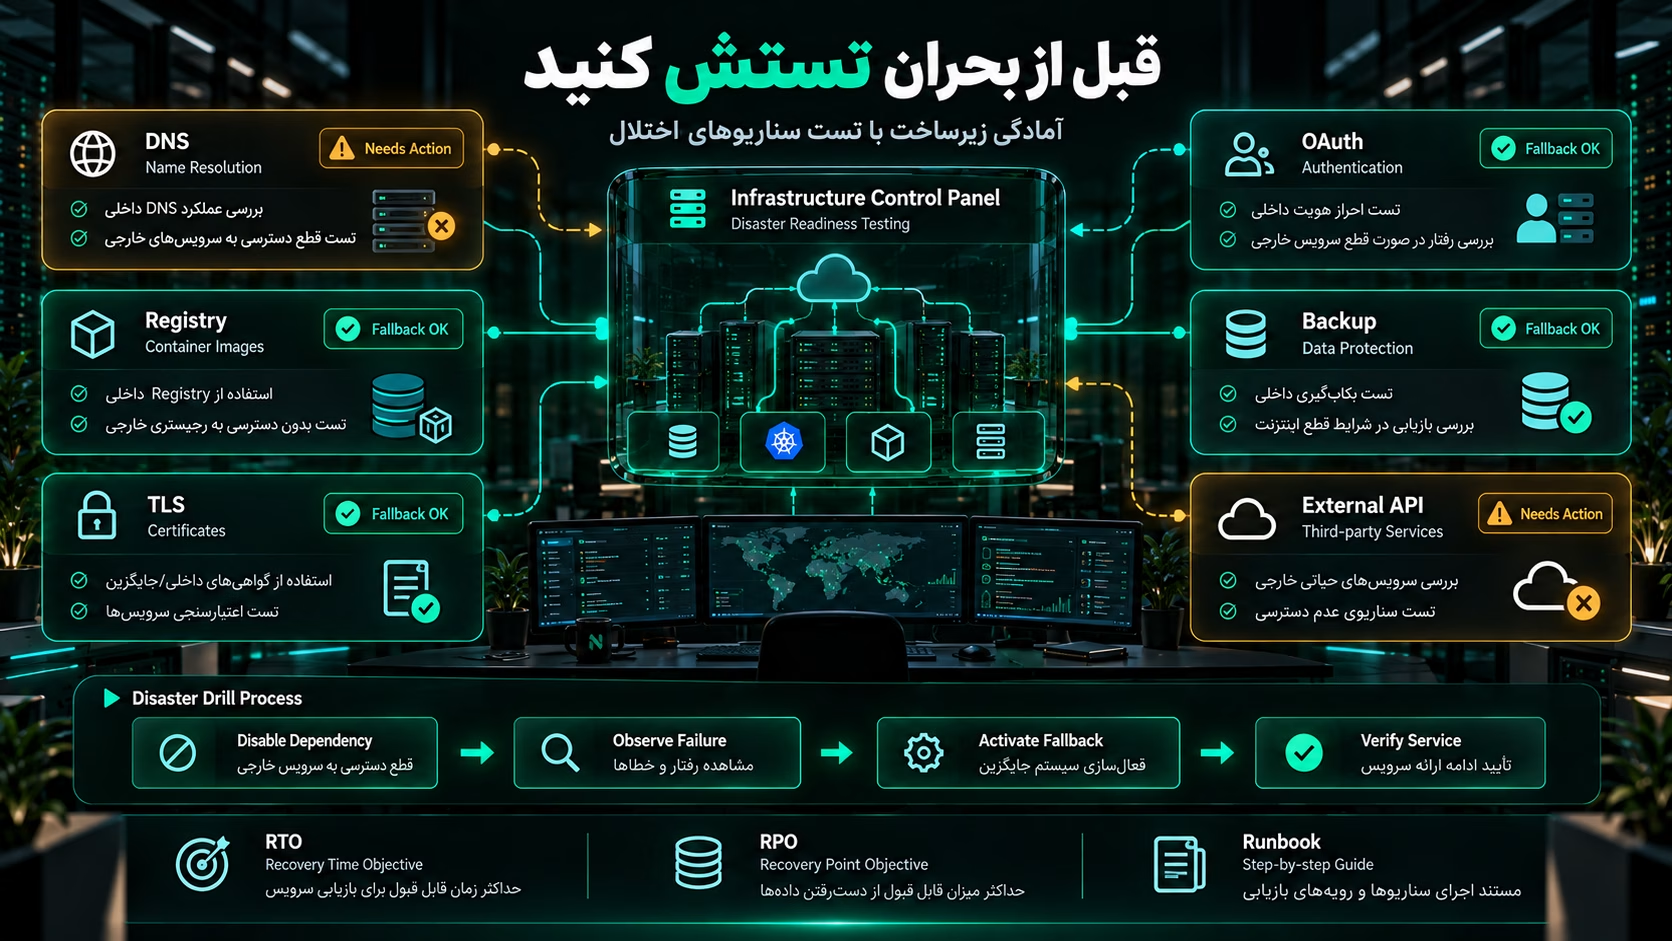
۱۳. Disaster Drill انجام دهید
تا زمانی که Failure را Test نکرده باشید، نمیدانید Plan واقعاً کار میکند یا نه.
در Staging میتوانید دسترسی خارجی یک Service را موقتاً Block کنید.
مثلاً بررسی کنید:
Docker Hub unavailable
→ Deployment works?

Google OAuth unavailable
→ Admin can login?

External DNS management unavailable
→ DNS still resolves?

External Backup unavailable
→ Local restore works?

External API unavailable
→ Application degrades gracefully?
این تمرین مشکلاتی را پیدا میکند که با خواندن Diagram معماری دیده نمیشوند.
RTO و RPO را مشخص کنید
دو مفهوم مهم برای Continuity:
RTO — Recovery Time Objective
حداکثر زمانی که میتوانید سرویس Down باشد.
مثلاً:
RTO = 30 minutesRPO — Recovery Point Objective
حداکثر مقدار Data Loss قابل قبول.
مثلاً:
RPO = 15 minutesاین دو عدد تعیین میکنند Backup و معماری Fallback شما باید چقدر جدی باشد.
سرویسی با:
RTO = 24 hoursنیاز متفاوتی با سرویس:
RTO = 5 minutesدارد.
چکلیست نهایی آمادگی DevOps برای اختلال اینترنت
تمام سرویسهای خارجی را Inventory کردهایم
وابستگیهای Critical مشخص شدهاند
DNS یک Single Point of Failure نیست
DNS سرویسهای داخلی مستقل است
برای CDN و Reverse Proxy مسیر اضطراری طراحی شده
Login مدیریتی فقط به OAuth خارجی وابسته نیست
Break-glass Account داریم
حداقل یک Backup قابل دسترس داخلی داریم
Restore Backup واقعاً تست شده
Imageهای Critical داخل Registry داخلی وجود دارند
Packageهای مهم Cache یا Mirror شدهاند
Production Deploy نیاز حداقلی به اینترنت دارد
Templateهای OS بهروز هستند
Certificate Expiration Monitoring داریم
Renewal TLS تست شده
Monitoring داخلی قابل دسترس داریم
APIهای خارجی Failure Mode مشخص دارند
Runbook Incident آماده است
Disaster Drill دورهای انجام میدهیم
RTO و RPO سرویسهای مهم مشخص شدهاند
از کجا شروع کنیم؟
اگر زیرساخت بزرگی دارید، انجام همه این موارد در یک روز ممکن نیست.
بهتر است براساس Impact اولویتبندی کنید.
Priority 1 — سرویسهای حیاتی
DNS
Authentication
Database Backup
Container Registry
TLS
Priority 2 — عملیات و Deployment
Package Repository
CI/CD
Monitoring
Git
Artifact Storage
Priority 3 — ابزارهای جانبی
Analytics
AI Tools
External Dashboards
Non-critical SaaS
این ترتیب کمک میکند انرژی تیم ابتدا روی چیزهایی صرف شود که نبودشان واقعاً سرویس را متوقف میکند.
ارتباط این موضوع با زیرساخت نتزو
بخشی از آمادگی برای اختلال باید توسط خود تیم DevOps انجام شود، اما Provider هم در نقطه شروع زیرساخت نقش دارد.
یکی از اقداماتی که اخیراً در نتزو انجام شده، بهروزرسانی تمام تمپلیتهای سیستمعامل و پکیجهای موجود در آنها است.
این کار کمک میکند VPS جدید با یک OS Image قدیمی شروع نشود و برای رسیدن به وضعیت بهروز، وابستگی کمتری به دانلود حجم بزرگی از اصلاحیههای گذشته داشته باشد.
در کنار آن، زیرساخت نتزو نیز به فایروالهای پیشرفته و سیستمهای IDS/IPS مجهز شده است تا کنترلهای امنیتی شبکه تقویت شوند.
اما در نهایت، تابآوری واقعی حاصل همکاری چند لایه است:
Provider Infrastructure
+
Operating System
+
Application Architecture
+
Backup
+
DevOps Processes
+
Incident Planningهیچکدام بهتنهایی کافی نیستند.
جمعبندی
اختلال اینترنت نباید اولین زمانی باشد که متوجه شویم زیرساخت ما به چه سرویسهایی وابسته است.
DNS خارجی، OAuth، Container Registry، Backup، Package Repository، Certificate Authority و APIهای Third-party همگی میتوانند در شرایط خاص تبدیل به نقطه شکست شوند.
راهحل، حذف اینترنت یا حذف تمام سرویسهای خارجی نیست.
سرویسهای خارجی در بسیاری از موارد بهترین انتخاب هستند.
هدف این است که برای اجزای Critical بدانیم:
اگر فردا این سرویس در دسترس نبود، چه اتفاقی برای سیستم ما میافتد؟
اگر پاسخ این سؤال مشخص نیست، همان بخش باید وارد Backlog زیرساخت شود.
یک معماری مقاوم معمولاً سه ویژگی دارد:
وابستگیهایش را میشناسد
↓
برای Critical Dependency مسیر جایگزین دارد
↓
و آن مسیر جایگزین را واقعاً تست کرده استبرای DevOps، آمادگی قبل از بحران همیشه ارزانتر و سادهتر از Debug کردن زیرساخت در وسط بحران است.
سوالات متداول
آیا باید تمام سرویسهای خارجی را حذف کنیم؟
خیر. هدف کاهش وابستگیهای غیرقابلکنترل و داشتن Fallback برای سرویسهای Critical است، نه حذف سرویسهای خارجی.
آیا باید IP اصلی Server را برای زمان قطع CDN در اختیار کاربران بگذاریم؟
معمولاً این کار نباید بدون طراحی امنیتی انجام شود. Direct Origin Access میتواند CDN، WAF یا Access Control موجود را دور بزند. مسیر اضطراری باید از قبل طراحی و محدود شده باشد.
برای Docker بهترین کار چیست؟
Imageهای Production و Dependencyهای Critical را از قبل داخل Registry تحت کنترل خودتان نگهداری کنید. Registry Mirror یا Proxy Cache نیز میتواند Pullهای خارجی را کاهش دهد.
آیا یک Backup روی S3 کافی است؟
از نظر Durability ممکن است سرویس قدرتمندی باشد، ولی برای Business Continuity بهتر است Failure Domain دسترسی را هم در نظر بگیرید و برای دادههای Critical نسخهای قابل Restore در مسیر مستقل داشته باشید.
برای Let's Encrypt چه کاری انجام دهیم؟
Expiration را Monitor کنید، Automation را بررسی کنید و با certbot renew --dry-run مطمئن شوید Renewal کار میکند. Certificateها را فقط به دلیل نگرانی از اختلال، بدون نیاز Force Renew نکنید.
آیا Google OAuth در زمان نبود اینترنت خارجی کار میکند؟
برای Login جدید معمولاً Application باید بتواند با سرویسهای Identity مربوط ارتباط برقرار کند. برای دسترسیهای Critical بهتر است Break-glass Access مستقل و از قبل تستشده داشته باشید.